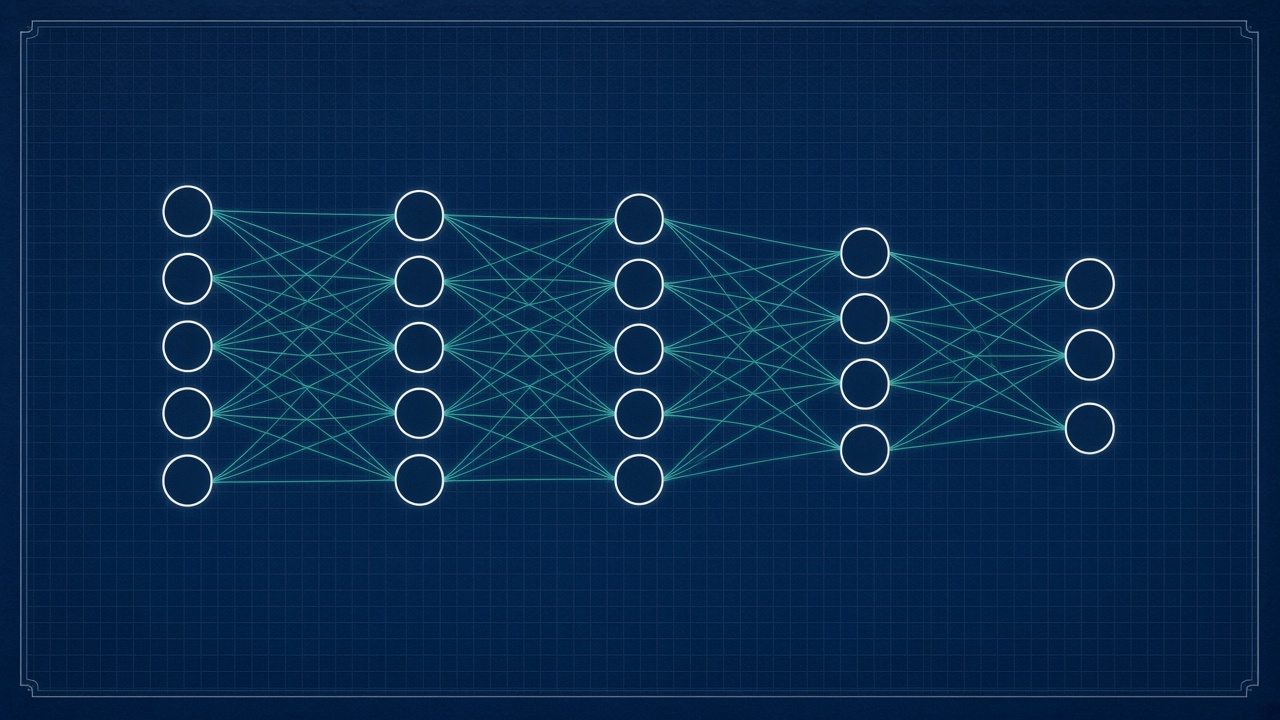
Многослойный перцептрон (MLP) — башня аффинных преобразований и поэлементных активаций. Для слоя \(\ell\):
На входе \(\mathbf{a}^{(0)}=\mathbf{x}\). На выходе \(\mathbf{a}^{(L)}=\hat{\mathbf{y}}\). Если обрабатывают сразу пакет из \(n\) примеров, те же формулы пишут матрицами:
Здесь \(A\in\mathbb{R}^{n\times d}\) — строки-примеры. Векторизация важна не для красоты: современные ускорители умеют именно плотные матричные произведения.
Теорема об универсальном приближении
Даже сеть с одним скрытым слоем достаточной ширины может приблизить любую непрерывную функцию на компакте с любой точностью. Формально: для непрерывной \(f:K\to\mathbb{R}\) и \(\varepsilon>0\) найдутся \(m\), веса и смещения такие, что
Теорема не говорит, как найти эти веса и сколько нейронов нужно на практике. Глубина часто выгоднее ширины: она задаёт иерархию признаков.
Нормализация пакета
Чтобы сигнал не «уплывал» по масштабу, между слоями ставят batch normalization. Для активации \(h\) в мини-пакете:
\(\mu_B,\sigma_B^2\) считают по текущему пакету, \(\gamma,\beta\) обучаются. Layer norm делает то же по признакам одного примера — так удобнее в NLP.
Инициализация
Если веса брать слишком большими, активации взрываются; слишком маленькими — затухают. Схема Xavier / Glorot для симметричных активаций:
Для ReLU чаще берут He-инициализацию: дисперсия \(2/n_{\mathrm{in}}\).