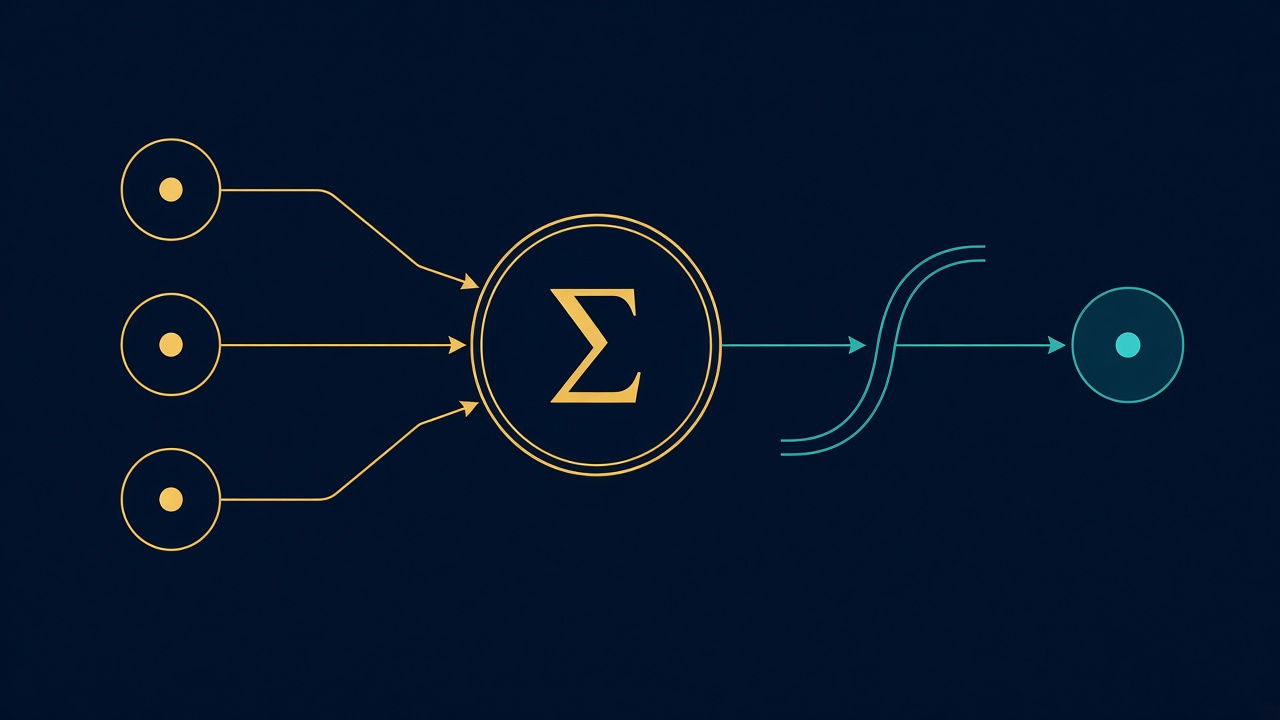
Исторически первым вычислительным «нейроном» считают модель Маккаллока — Питтса (1943) и перцептрон Розенблатта (1958). Оба описывают одно и то же: признаки умножаются на веса, складываются, затем сравниваются с порогом.
Линейный предиктор
Пусть пример задан вектором \(\mathbf{x} \in \mathbb{R}^d\). Перцептрон хранит веса \(\mathbf{w} \in \mathbb{R}^d\) и смещение \(b \in \mathbb{R}\):
Геометрически уравнение \( \mathbf{w}^\top \mathbf{x} + b = 0 \) задаёт гиперплоскость. Знак \(f(\mathbf{x})\) говорит, по какую сторону от плоскости лежит точка.
Правило решения
Классический перцептрон выдаёт метку класса через функцию знака:
Правило обучения Розенблатта простое. Если пример \((\mathbf{x}, y)\) классифицирован верно, веса не трогают. Если ошибка, веса сдвигают в сторону правильного класса:
Здесь \(\eta > 0\) — скорость обучения, \(y \in \{+1,-1\}\). Теорема о сходимости перцептрона утверждает: если классы линейно разделимы, алгоритм найдёт разделяющую плоскость за конечное число шагов.
Вероятностный взгляд
Современные сети почти не используют \(\operatorname{sign}\). Удобнее логистическая регрессия: та же линейная форма, но выход — вероятность класса
Логит \(z\) можно читать как логарифм отношения шансов:
Норма и отступ
Расстояние от точки до разделяющей плоскости равно
Метод опорных векторов максимизирует минимальный отступ. Нейронные сети обычно не оптимизируют отступ напрямую, но идея та же: уверенные предсказания лежат далеко от границы.